Cómo medir el tráfico de LLMs en GA4 con Cloudflare y GTM Server-Side
Si ya tienes GTM Server-Side y te interesa saber si tu web está siendo usada en los razonamientos propios de los LLM no te pierdas este post.
Los modelos de IA ya no son solo una fuente de tráfico de referencia. Cada vez más organizaciones necesitan responder preguntas como:
- ¿Qué contenidos consume ChatGPT?
- ¿Cuándo accede Claude a nuestra documentación?
- ¿Qué páginas consulta Gemini?
- ¿Qué porcentaje de tráfico proviene de procesos de entrenamiento frente a consultas de usuarios?
El problema es que Google Analytics no está diseñado para medir este tipo de interacciones de manera nativa.
En este artículo veremos cómo construir una solución para detectar agentes LLM en Cloudflare, enviarlos a Server-side GTM y analizarlos posteriormente en GA4.
El problema
Cuando un usuario visita una web desde el navegador, GA4 recibe información mediante JavaScript.
El flujo habitual sería:
Usuario
↓
Navegador
↓
gtag.js / GTM
↓
GA4
Sin embargo, cuando accede un agente de IA ocurre algo diferente:
ChatGPT
Claude
Gemini
Perplexity
↓
HTTP Request
↓
Servidor
No existe navegación real ni ejecución de JavaScript.
Por tanto:
- No se dispara GTM, ni TiQ, ni Adobe Launch,…
- No se ejecuta gtag.js, ni ninguna otra librería JS
- No existe sesión, ya que es tráfico de un bot contra servidor
y la visita desaparece de la analítica tradicional.
Arquitectura propuesta, la de nuestra web
Para resolverlo hemos utilizado:
Astro
+
Cloudflare Pages Functions
+
Server-side GTM
+
GA4
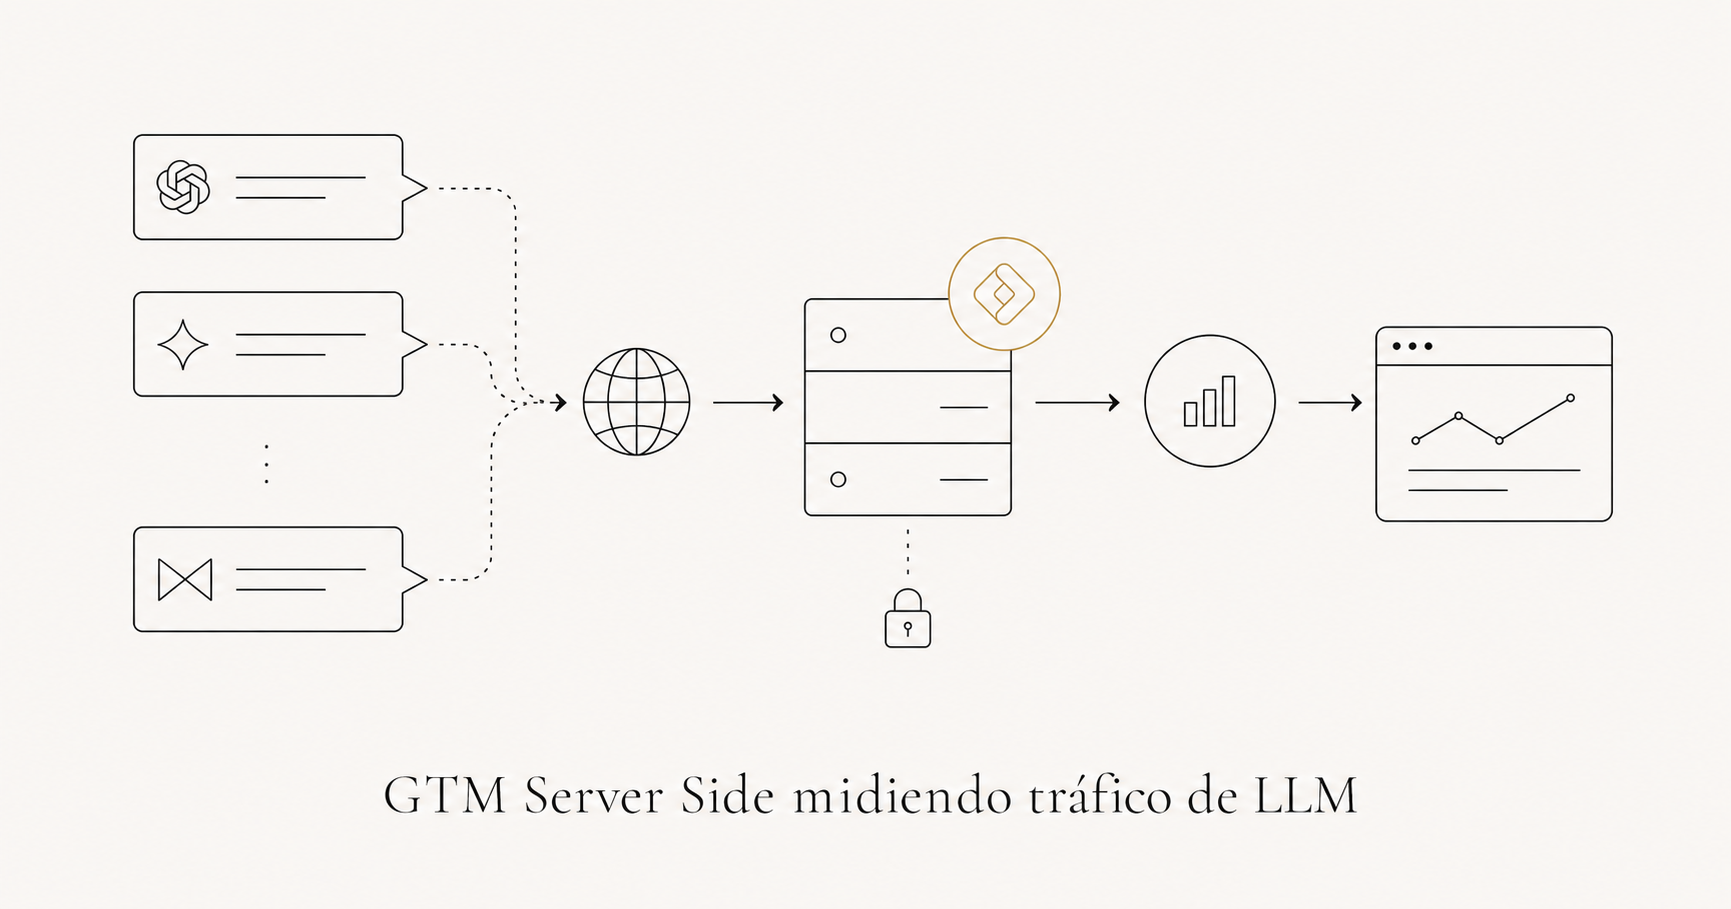
El flujo resultante es:
LLM
↓
Cloudflare Function
↓
Clasificación del agente
↓
Server-side GTM
↓
GA4
Detectando agentes IA
La primera capa consiste en analizar el User-Agent de cada petición.
Por ejemplo:
{
  regex: /ChatGPT-User/i,
  provider: "OpenAI",
  type: "reasoning"
}
o:
{
  regex: /ClaudeBot/i,
  provider: "Anthropic",
  type: "training"
}
Esto permite diferenciar:
OpenAI
Anthropic
Google
Perplexity
Microsoft
...
e incluso clasificar el propósito del acceso:
reasoning
retrieval
training
search
...
Clasificando el contenido
Además del agente, es importante clasificar las URLs.
Por ejemplo:
function getPageType(path) {

  if (path.startsWith("/blog/")) {
    return "blog";
  }

  if (path.startsWith("/servicios/")) {
    return "service";
  }

  return "other";
}
De esta forma podemos responder preguntas como:
¿Qué contenido se consume más en mi sitio web por los LLM? ¿Documentación o artículos? ¿Qué temas interesan más a Claude, ChatGPT, Gemini,…? ¿Están usando mi site para entrenarse o es usado dentro de razonamientos a preguntas de usuario?
Y así un sin fin de preguntas que pueden venirnos a la cabeza cuando estamos leyendo esto.
Primera versión: Measurement Protocol (sin GTM server side)
Para validar rápidamente la solución utilizamos inicialmente Measurement Protocol.
El payload enviado tenía un formato parecido a este:
{
  "client_id": "OpenAI-ChatGPT-User",
  "events": [
    {
      "name": "llm_request_MP",
      "params": {
        "llm_provider": "OpenAI",
        "llm_agent": "ChatGPT-User",
        "llm_agent_type": "reasoning",
        "page_type": "blog"
      }
    }
  ]
}
El flujo quedaba así:
Cloudflare Function
↓
Measurement Protocol
↓
GA4
Esta opción permitió validar rápidamente:
- La detección de agentes.
- La clasificación por proveedor.
- La llegada de eventos a GA4.
- La viabilidad de la solución.
Integrando GTM Server Side en el camino
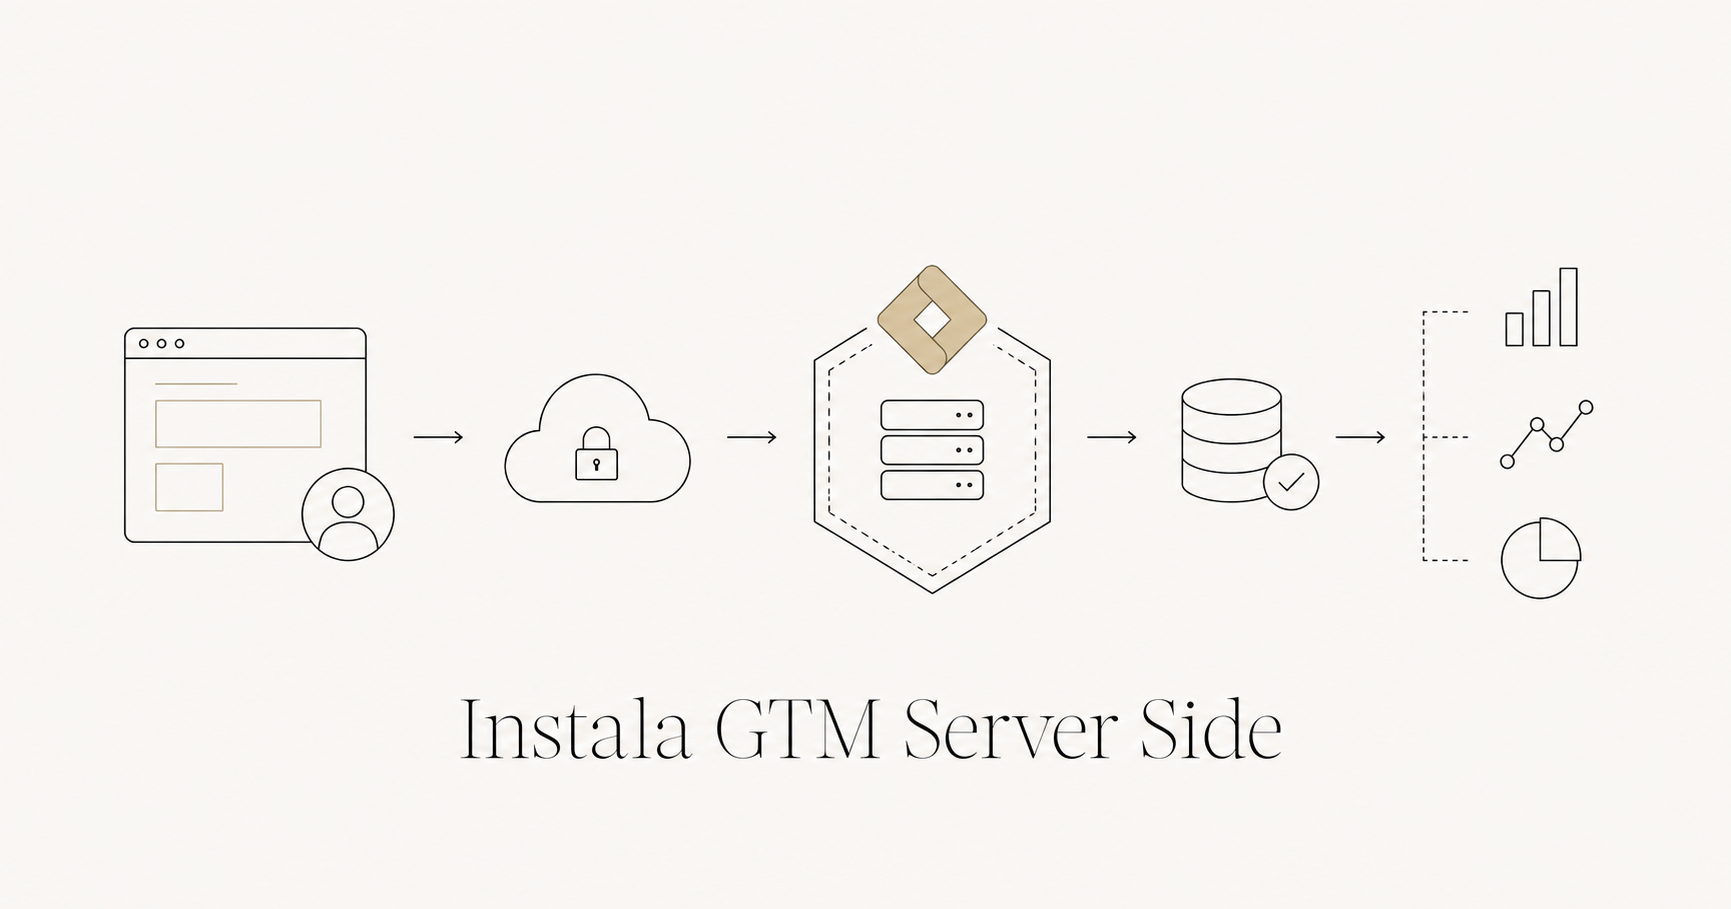
Si estas leyendo esto, imagino que sabes que desde ssGTM ya nos ofrece una serie de clientes por defecto y en concreto uno de Measurement Protocol:
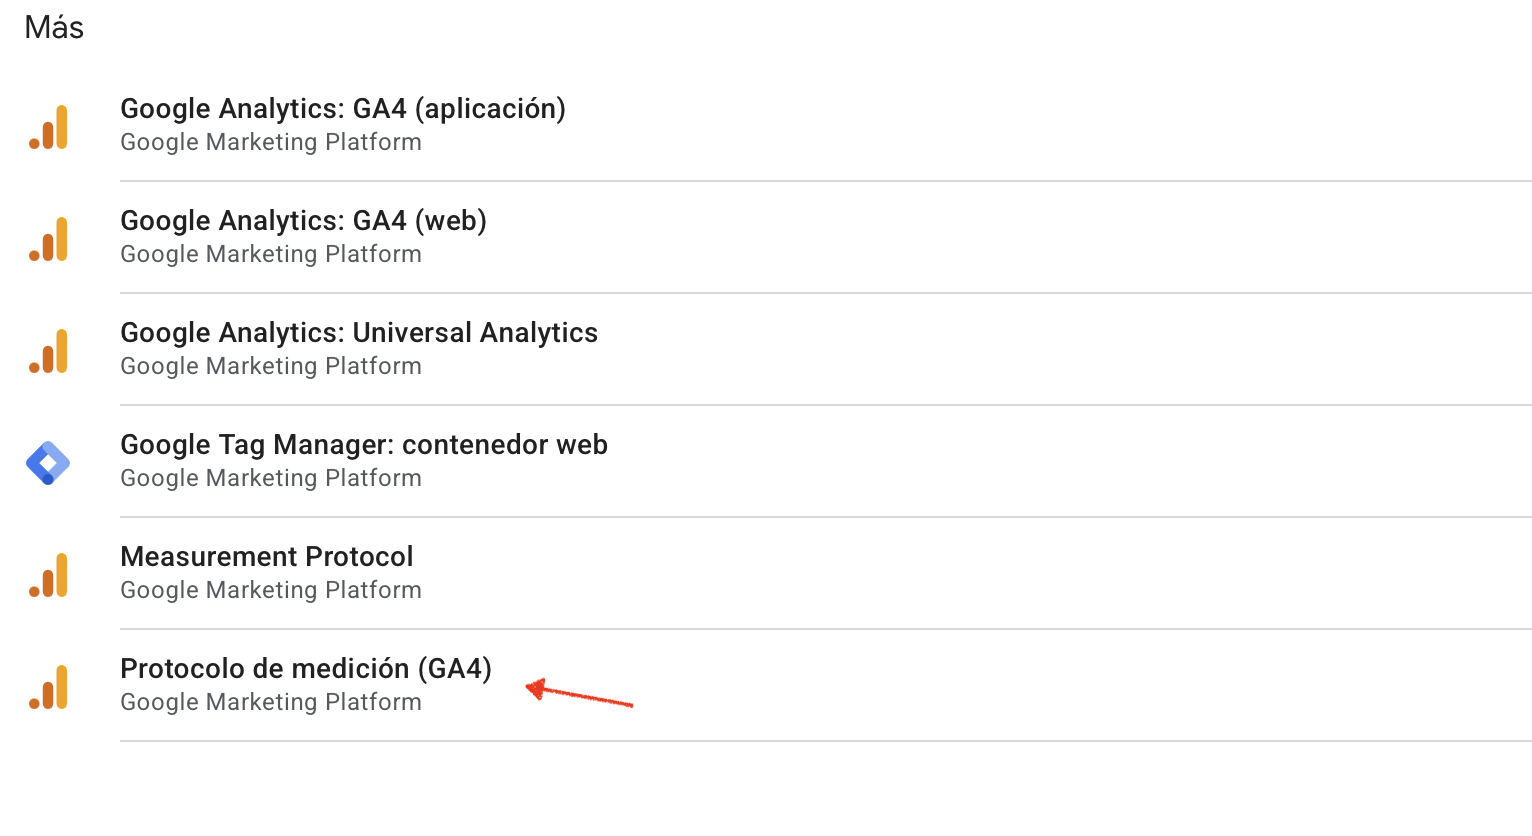
Pues bien, lo que hicimos como segundo paso es meter a GTM Server Side en medio, para que desde él se intercepte la petición y se envíe a Measurement Protocol desde aquí. Esto nos permitió ver que nuestro GTM Server Side estaba bien instalado, recordad el post y realizar el envío a Google ya desde aquí, haciéndonos más ágil el trabajo a la hora de mapear, transformar,…
En este paso el payload enviado tenía un formato parecido al anterior, ya que ahora interceptábamos esta información y se la pasábamos al cliente en cuestión:
{
  "client_id": "OpenAI-ChatGPT-User",
  "events": [
    {
      "name": "llm_request",
      "params": {
        "llm_provider": "OpenAI",
        "llm_agent": "ChatGPT-User",
        "llm_agent_type": "reasoning",
        "page_type": "blog"
      }
    }
  ]
}
El flujo pasaba a tener un punto más:
Cloudflare Function
↓
Server-side GTM
↓
Measurement Protocol
↓
GA4
Evolucionando hacia un endpoint propio
Una vez validado el flujo, decidimos evolucionar la arquitectura hacia un endpoint personalizado:
POST /llm
Y que este fuera gestionado por un cliente específico (personalizado) dentro de GTM Server Side.
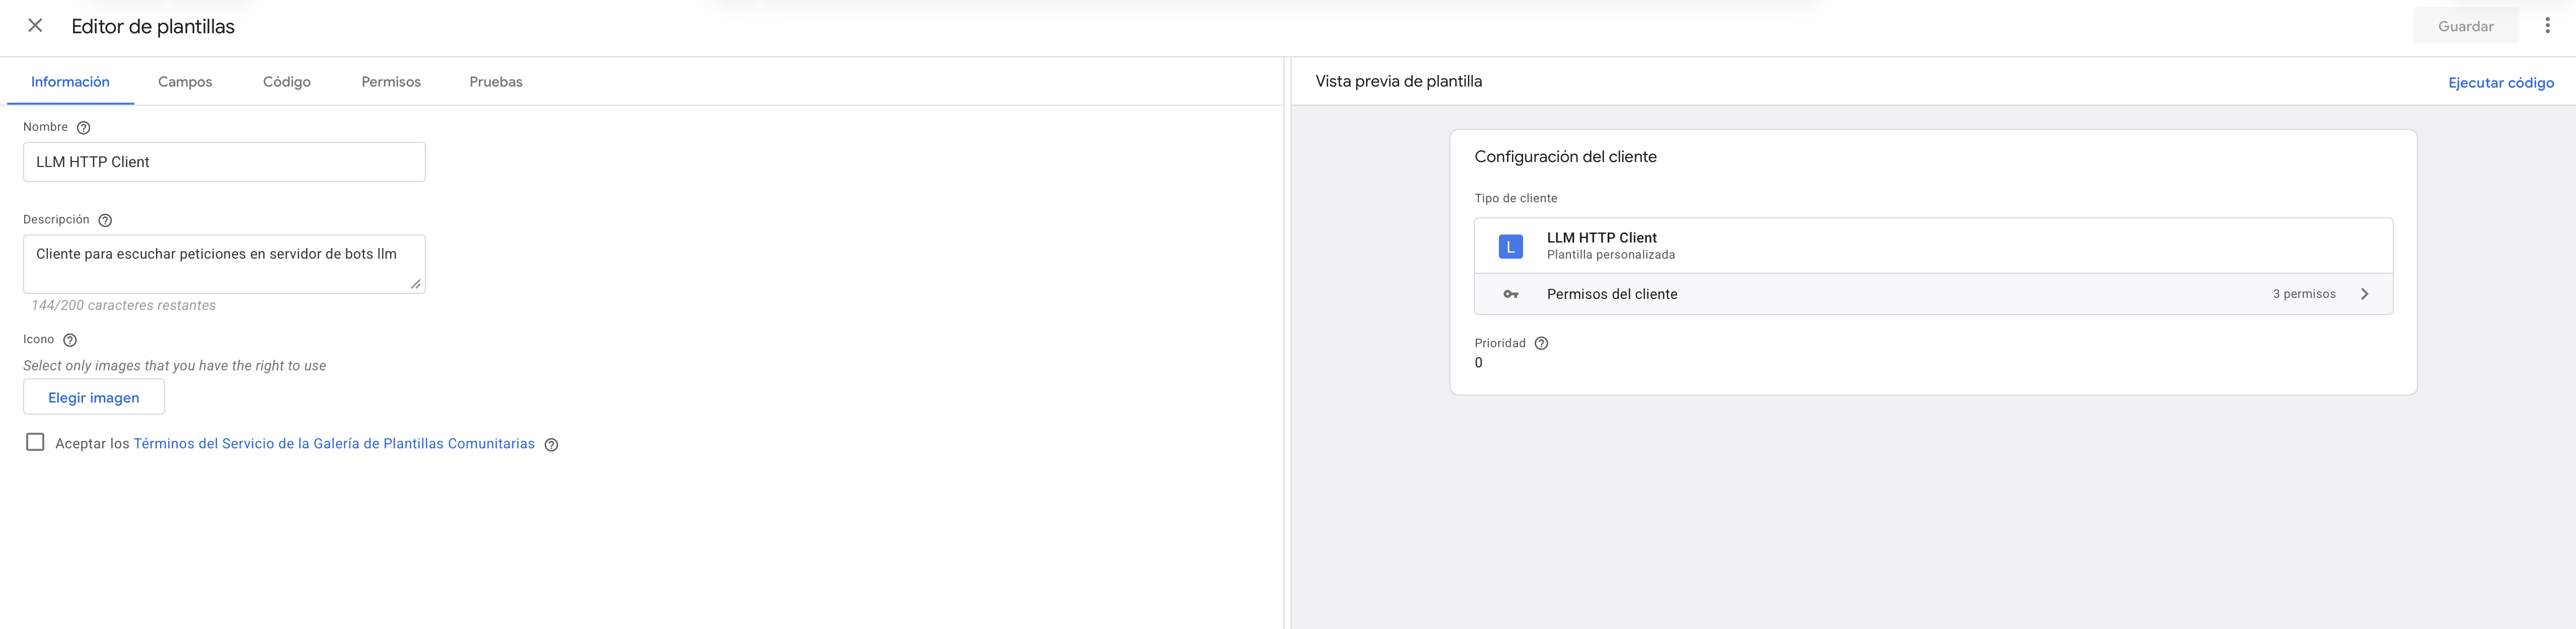
El payload pasó a ser mucho más sencillo, ya no necesitábamos una estructura tan especifica:
{
  "event_name": "llm_request",
  "llm_provider": "OpenAI",
  "llm_agent": "ChatGPT-User",
  "llm_agent_type": "reasoning",
  "page_path": "/blog/google-tag-gateway/",
  "page_type": "blog"
}
Y ahora vienen algunas preguntas que también nos hicimos nosotros…
¿Por qué utilizar un cliente personalizado?
Measurement Protocol funciona correctamente, pero presenta algunas limitaciones, sobre todo el anclaje a la estructura que nos da google y también cuando queremos gestionar eventos propios todo se vuelve más complejo.
Con un cliente personalizado conseguimos:
- Un esquema de datos completamente controlado.
- Mayor flexibilidad para evolucionar el modelo.
- Eventos visibles de forma nativa en Server-side GTM.
- Mejor experiencia de depuración.
- Independencia respecto al formato específico de GA4.
La nueva arquitectura queda así:
Cloudflare Function
↓
POST /llm
↓
LLM Client (SGTM)
↓
Evento llm_request
↓
GA4
¿Qué información merece la pena almacenar?
Más allá del proveedor de IA, nosotros llegamos a la conclusión de que es suficiente almacenar dimensiones que permitan contextualizar el acceso y estas son las que a nosotros nos ayudaron a entender este tráfico:
llm_provider
llm_agent
llm_agent_type
page_path
page_type
country
colo
Si trabajamos con Cloudflare, además podemos aprovechar información adicional que nos da su módulo de IA Crawler como:
bot_score
verified_bot
asn
asOrganization
Esto permite diferenciar entre pruebas internas, rastreadores genéricos y accesos potencialmente asociados a infraestructuras reales de OpenAI, Google, Anthropic o Microsoft.
Y ahora… ¿Qué análisis podemos construir?
Una vez los datos llegan a GA4 aparecen nuevas posibilidades de análisis.
Proveedores más activos
OpenAI Anthropic Google Perplexity Microsoft …
Tipos de uso de nuestra web
reasoning retrieval training search …
Contenido más consumido por este tráfico
/blog/google-tag-gateway /blog/gtm-server-side /blog/exploraciones-ga4 …
Distribución por categorías de los post
ANALYTICS TAG MANAGMENT FÚTBOL MÉTRICAS …
Consumo por agrupaciones de contenido
blog service guide documentation …
Pruebas con modelos reales
Uno de los descubrimientos más interesantes durante el desarrollo fue comprobar que no todos los modelos acceden a una web de la misma manera.
Mientras algunas plataformas realizan consultas directas a las URLs proporcionadas, otras pueden responder utilizando información previamente indexada o almacenada en caché.
Esto significa que la ausencia de tráfico no siempre implica ausencia de uso del contenido.
Precisamente por eso resulta tan interesante disponer de una capa propia de observabilidad sobre las interacciones de los modelos con nuestros activos digitales.
Conclusiones
La irrupción de los LLM obliga a replantear los modelos tradicionales de medición digital.
Una parte creciente del consumo de contenido ya no genera sesiones, usuarios o eventos web convencionales.
Detectar este tráfico a nivel de infraestructura permite empezar a responder preguntas estratégicas como:
- ¿Qué contenidos utilizan los modelos de IA?
- ¿Qué proveedores interactúan más con nuestra web?
- ¿Qué categorías generan mayor interés?
- ¿Cómo evoluciona nuestra visibilidad dentro de los ecosistemas de IA?
La combinación de un CDN como Cloudflare, Server-side GTM y GA4 ofrece una solución relativamente sencilla para construir una primera capa de medición sobre el consumo de contenidos por parte de modelos generativos.
Y probablemente sea solo el comienzo de una nueva disciplina analítica orientada a entender cómo las inteligencias artificiales descubren, interpretan y utilizan la información publicada en la web.
¿Tienes dudas sobre algún paso del proceso o manejas otro tipo arquitectura de solución? Escríbeme.